메모리
메모리와 프로세스
CPU는 작업을 하며 계속 메모리에서 데이터를 읽어와야 한다. 이 때 CPU에서 메모리를 오가는 속도가 빠른 것이 컴퓨터의 성능을 가를 것이다. 따라서 메모리에서 데이터를 읽어올 때 우리가 자주 쓰는 것과 자주 쓰지 않는 것, 앞으로 쓰이게 될 것으로 예상되는 데이터들을 미리 CPU에 가깝게 위치시키는 등 여러 가지 방식을 고안하게 되었고, 이에 메모리는 크게 3계층 구조로 이루어지게 되었다.
용량은 작고 비싸지만 CPU에서 물리적인 위치가 가깝고 속도가 제일 빠른 Cache
적당한 용량에 적당한 가격, CPU로부터 물리적인 거리가 적당한 Main Memory
큰 용량에 저렴한 가격, CPU에서 물리적으로 제일 멀며 속도가 제일 느린 Disk
이 메모리 계층 구조를 관리하는 것이 OS의 memory manager이다.
memory manager는 메모리 공간의 사용여부를 추적하여 프로세스에게 메인 메모리를 할당 및 해제하는 역할도 가지며
메인 메모리의 공간이 부족하다면 디스크와 메모리 사이를 swapping 하기도 한다.
Mono_programming
모노프로그래밍은 한번에 하나의 프로세스만 실행하는 것을 말한다.
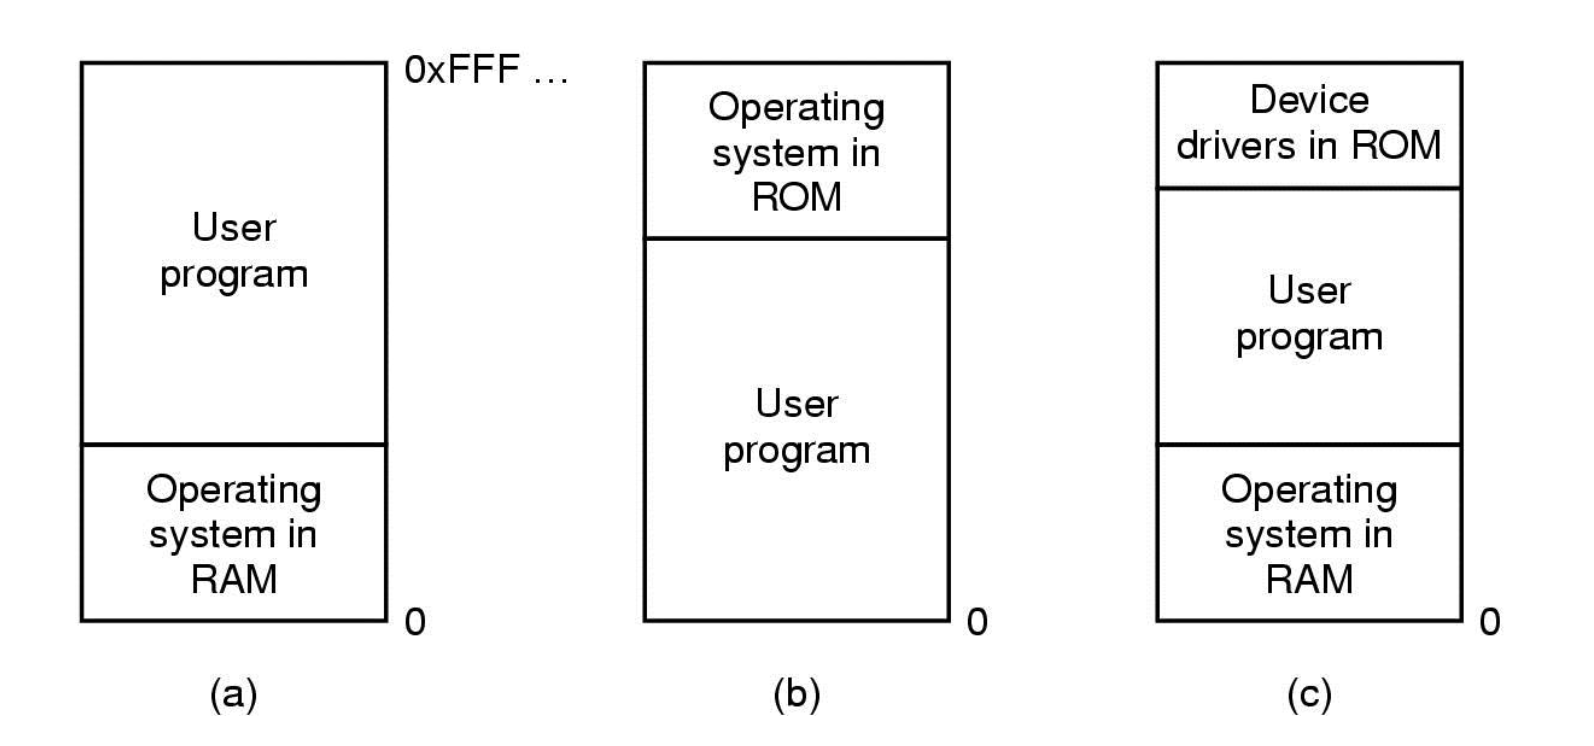
위와 같이 크게 세 가지 방법이 있는데
(a)는 RAM에 운영체제를 두고 그 위에서 유저 프로그램을 실행하는 방법(과거 메인 프레임이나 미니 컴퓨터에 많이 쓰던 방식이다.)
(b)는 ROM에 운영체제를 두고 Ram에서 유저 프로그램을 실행하는 방법(주로 palmtop computer나 임베디드에서 쓰인다고 한다.)
(c)는 PC에서 주로 사용하는 방식으로 RAM에 운영체제를 두고 그 위에서 유저 프로그램을 실행하되 ROM에 운영체제의 일부인 device driver 소프트웨어가 들어간다.
Multi_programming
멀티프로그래밍은 말 그대로 여러 프로세스를 동시에 실행하는 것으로 메모리에 여러 프로세스가 동시에 존재하게 된다.
기본적으로 fixed-size(고정된 크기)로 메모리의 공간을 나누어 할당하게 되는데 이를 fixed partitions이라고 한다.
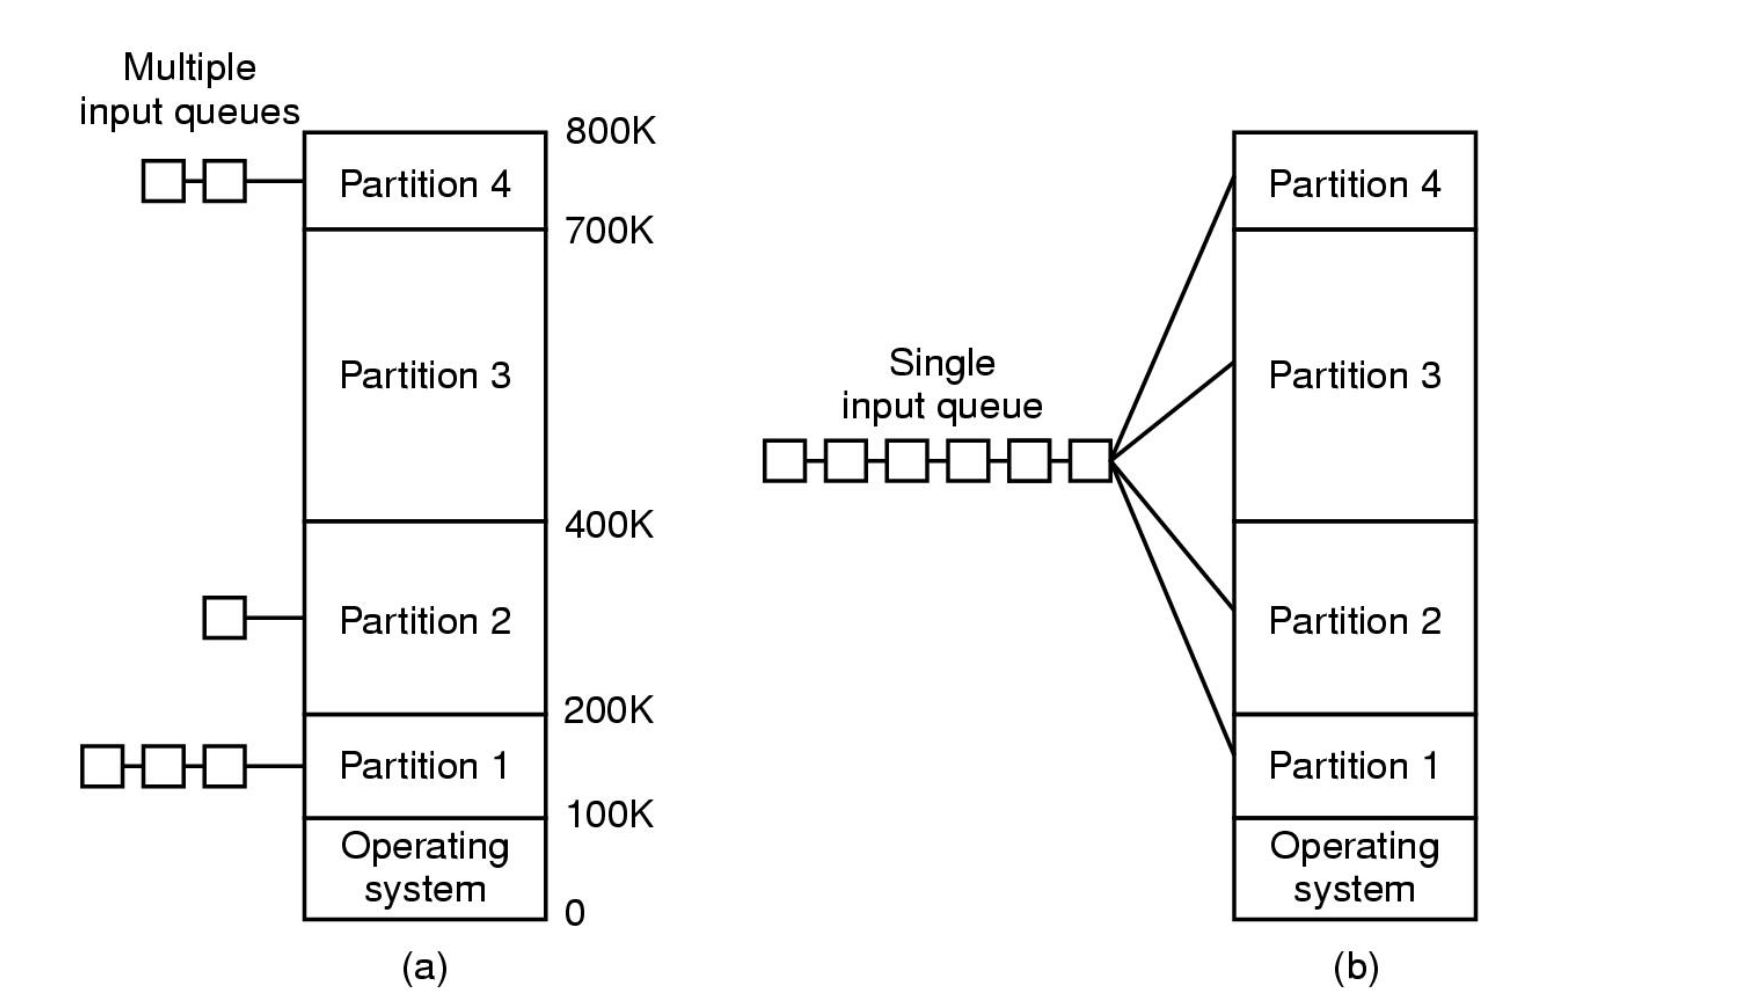
이 또한 위처럼 a, b 두 가지 방식이 있다.
먼저 (a)는 다양한 fixed-size의 partition들로 나누고 각 파티션에 큐를 두어 프로세스를 실행한다.
이 때 운영체제는 작업이 들어오면 이 작업이 들어갈 수 있는 파티션 크기 중 가장 작은 파티션의 큐에만 작업을 추가한다.
이렇게 되면 크기가 작은 작업만 들어온다면 크기가 큰 파티션의 메모리는 낭비될 것이다.
이에 개선된 것으로 (b)가 등장하였는데 큐를 하나만 두어 작업을 처리한다. 그리고 현재 큐에서 꺼낸 작업이 들어갈 수 있는 파티션으로
넣어준다. 이렇게 되면 이전의 문제가 해결될 것이다.
Relocation & Protection
멀티프로그래밍에서 프로그램이 어디 메모리에 할당될지 미리 알 수 없으므로 같은 메모리 영역을 동시에 두 곳 이상이 동시에 존재할 수 있어 relocate와 protect가 필요한데, 먼저 protection은 하나의 파티션에서 실행중인 프로그램이 다른 파티션을 침범하면 안된다는 것이다.
프로텍션 구현을 위해 과거 IBM은 Protection Code를 사용했는데, 메모리를 0~1k, 1k~2k, 2k~4k, 4k~8k 등으로 쪼개고 각 조각마다 protection code를 할당한다.
이제 CPU가 프로세스를 실행할 때 PSW에 protection key가 할당된 채로 수행하는데, 특정 메모리에 접근하려 하면 PSW의 protection key와 메모리의 protection code를 비교하여 값이 같을 때에만 접근을 허용하는 방식으로 구현하였다.
Relocation은 메모리에 접근하는 주소를 바꾸는 것을 말한다.
컴파일 시 이 코드가 메모리에서 어떻게 할당받을지를 미리 알 수 없기 때문에 메모리 시작점을 0으로 두고 상대 주소로 변환하여 각각 주소를 할당한다. 이후 운영체제가 프로그램을 메모리에 실제로 올리면서 이 올리는 위치를 base로 하여 접근하는 '실제 메모리 주소'를 계산한다.
이를 구현할 때에는 2가지 방법이 있는데 첫째는 링커가 컴파일 된 결과물들을 합쳐 실행 파일로 만들 때 내부에 adress table을 만든다. 이후 운영체제가 이 테이블을 보고 상대주소를 실제주소로 만들어 실행한다.
다음으로 베이스 레지스터와 리미트 레지스터를 사용하는 방법인데, 베이스 레지스터는 프로세스가 들어간 파티션의 시작 주소를 갖고 있고 이를 이용해 프로그램 실행 시 상대주소를 더해 절대주소를 계산하는 방법이다. 리미트 레지스터는 파티션의 크기 값을 갖고 있어 상대주소 값이 파티션의 크기를 넘어가면 Access violation 에러를 발생시켜 다른 파티션을 침범하지 못하도록 막는다.
이 방법은 프로그램 로딩은 빠르나 베이스 레지스터와 리미트 레지스터 연산을 해야 하므로 실행 시간은 오래 걸리는 단점이 있다.
Swapping
스와핑은 각 프로세스를 메모리에 통으로 가져와 수행하며 디스크에 돌려놓고 하는 것을 말한다.
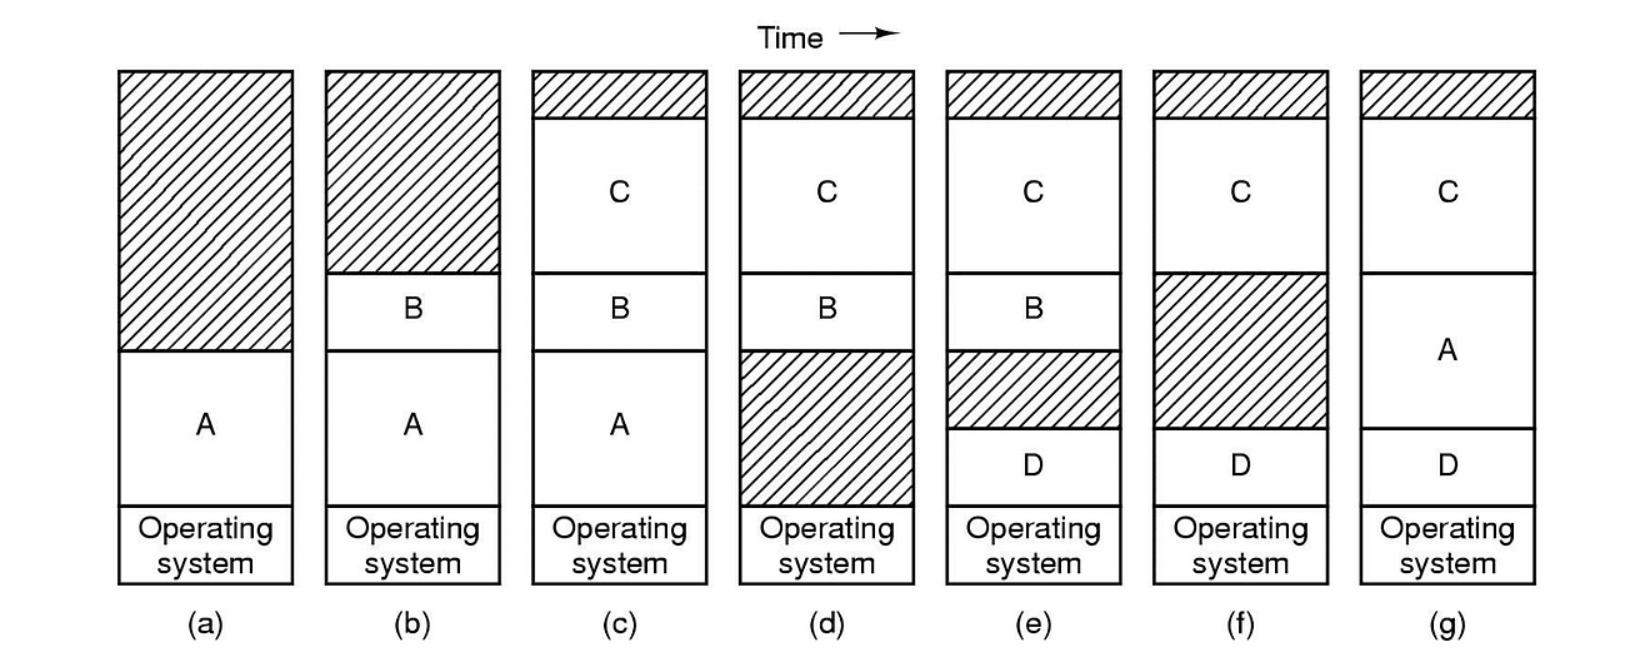
왼쪽부터 시작한다.
A가 파티션을 할당받고, B, C까지 받는다. 이제 D가 받아야 하는데 남은 파티션은 크기가 부족하다. 따라서 A를 다시 디스크로 보내고 그 공간에서 D를 실행한다. 이후 다시 A의 차례가 왔을 때 B를 디스크로 다시 보내고 그자리에 A를 실행하는 방식이다.
이 때 빗금친 영역들을 한데 모아 빈 공간을 만드는 것을 Memory Compaction, 메모리 압축이라고 한다.
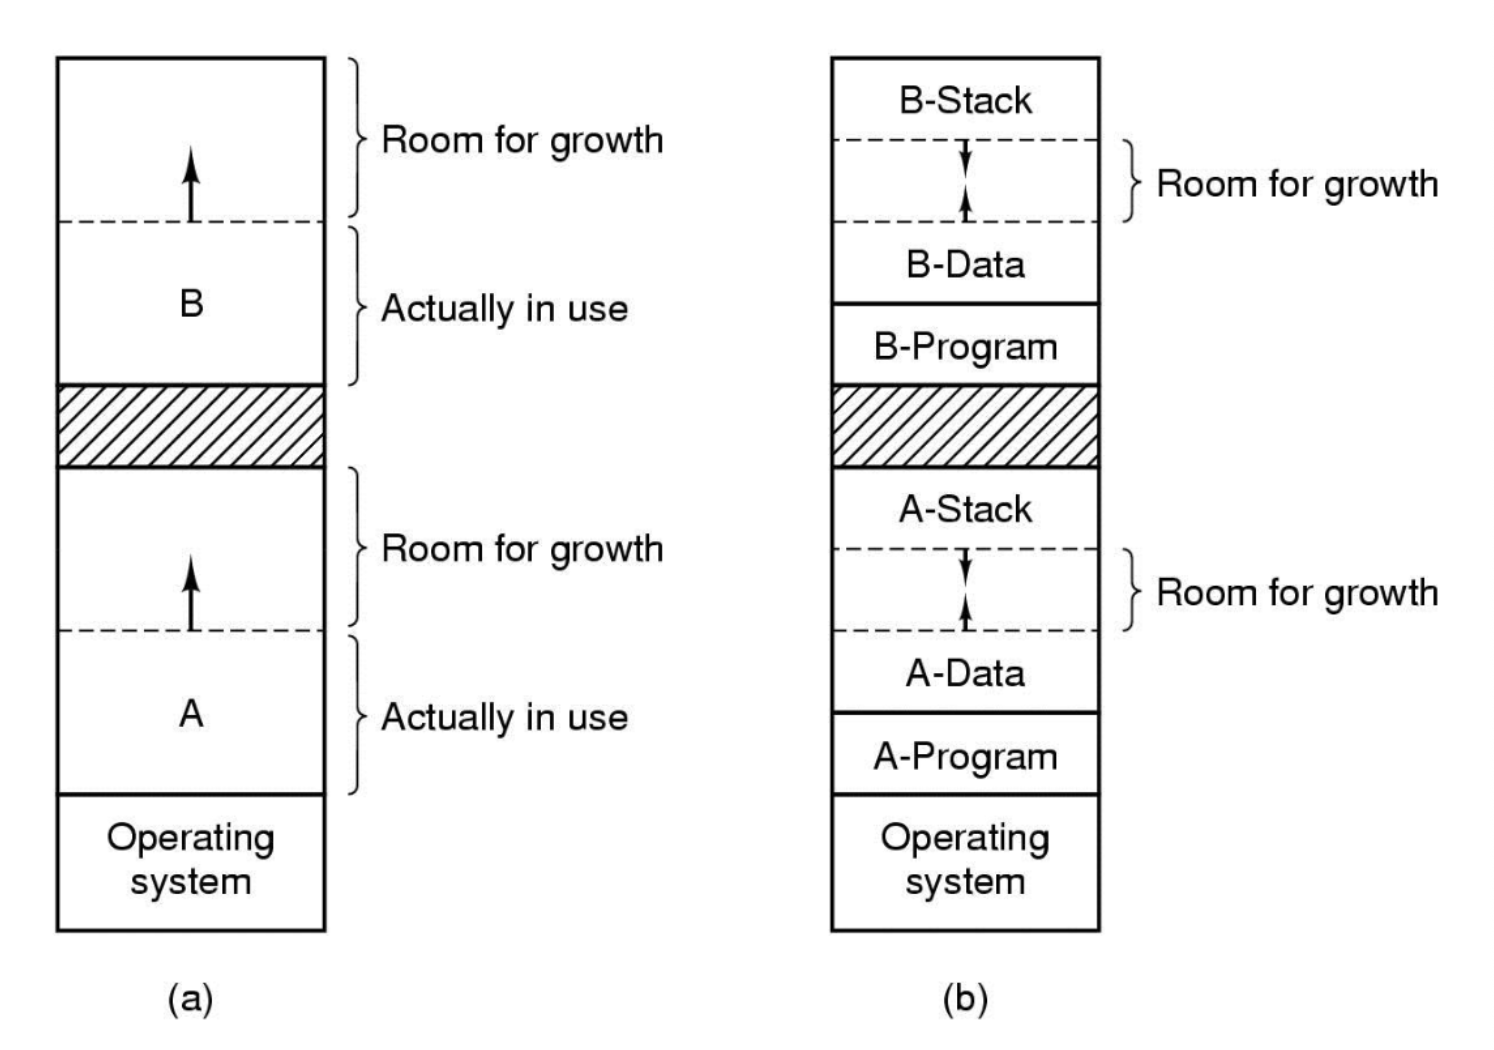
메모리에 프로세스를 할당할 때 위와 같이 실제 사용하는 영역에 여분 공간을 추가해준다.
UNIX에서는 (b)와 같이 할당한다. (앞서 배우던 메모리 영역으로 stack, data, text 세그먼트들로 이루어짐 - 코어 이미지)
Bit map
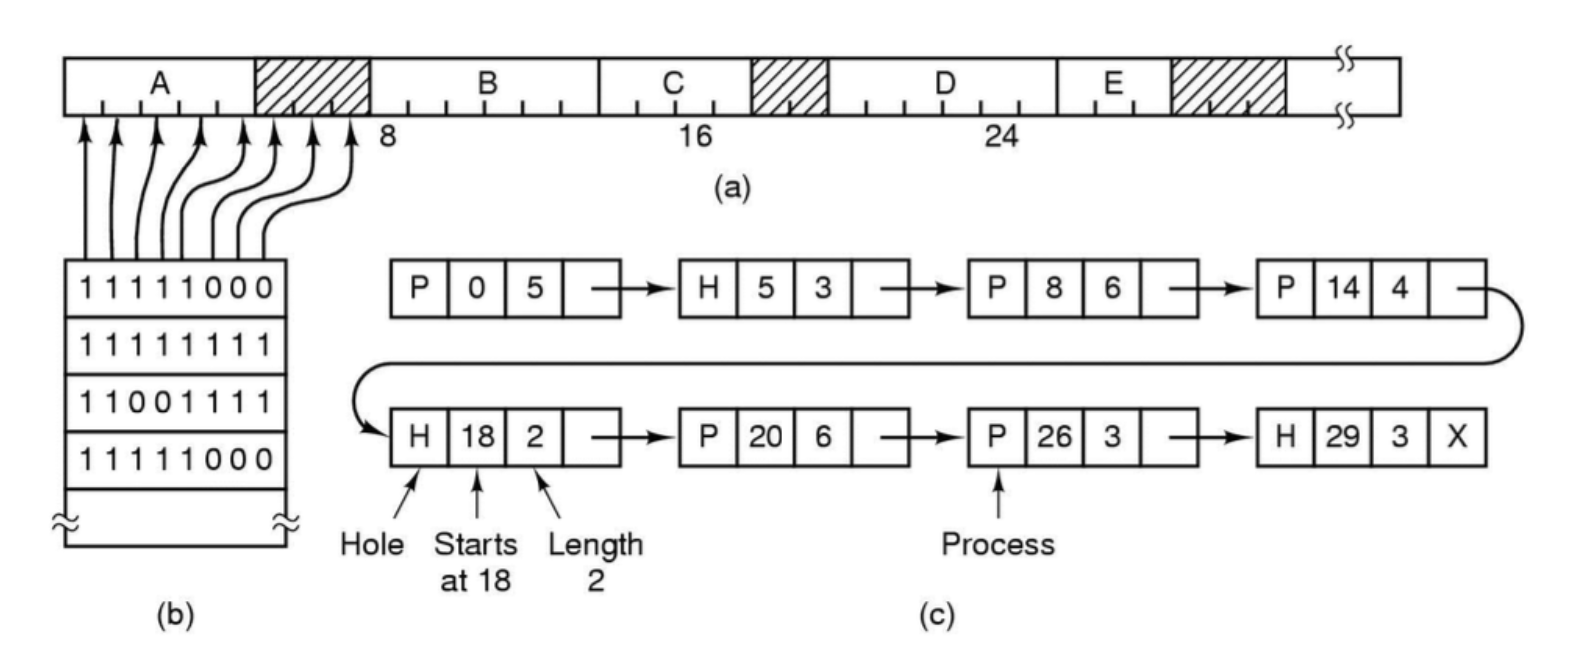
위 그림은 물리적인 메모리 공간에 할당된 프로세스를 bit map으로 관리하는 모습(b)과 링크드 리스트로 관리하는 모습(c)이다.
현재 5개의 프로세스가 존재하고 3개의 hole이 있다.
각각의 눈금은 일종의 프로세스 단위이고 A는 5개 유닛, B는 6개 유닛.. 인 셈이다.
이 allocation unit의 크기가 중요하다.
할당 단위가 작으면 전체 비트맵의 크기는 커지고 프로세스가 요구하는 사이즈에 맞추기가 쉬워 메모리 낭비가 줄어들 것이다.
반대로 할당 단위가 크면 전체 비트맵의 크기는 작아지고 요구 사이즈에 맞추기가 어려워 메모리 낭비가 심할 것이다.
즉 위의 사진은 1이 unit을 사용, 0이 hole인 것이다.
비트맵 방식을 사용하면 새로운 프로세스가 들어왔을 때 공간을 찾는 데 오래 걸리는 단점이 있다.
위 그림을 예로 들면, 5개의 유닛을 요구하는 프로세스가 들어왔을 때 연속되는 5개의 0을 순차적으로 찾아야 할 것이고 위에서는 끝까지 돌고도 찾지 못할 것이기 때문이다.
Free List(Linked List)
위의 (c)가 링크드 리스트를 활용한 방법이다.
각 노드는 네 가지 데이터를 저장하고, 이는 각각 (프로세스인지 홀인지 / 시작 allocation unit 번호 / 크기 / 다음 노드의 포인터)로 이루어져 있다.
(c)에서 (P,0,5,다음 노드의 주소)라 하면 0번에서 시작해 5개 크기의 unit을 할당
다음으로 5번에서 시작해 3개 크기만큼 'hole'인 것이다.
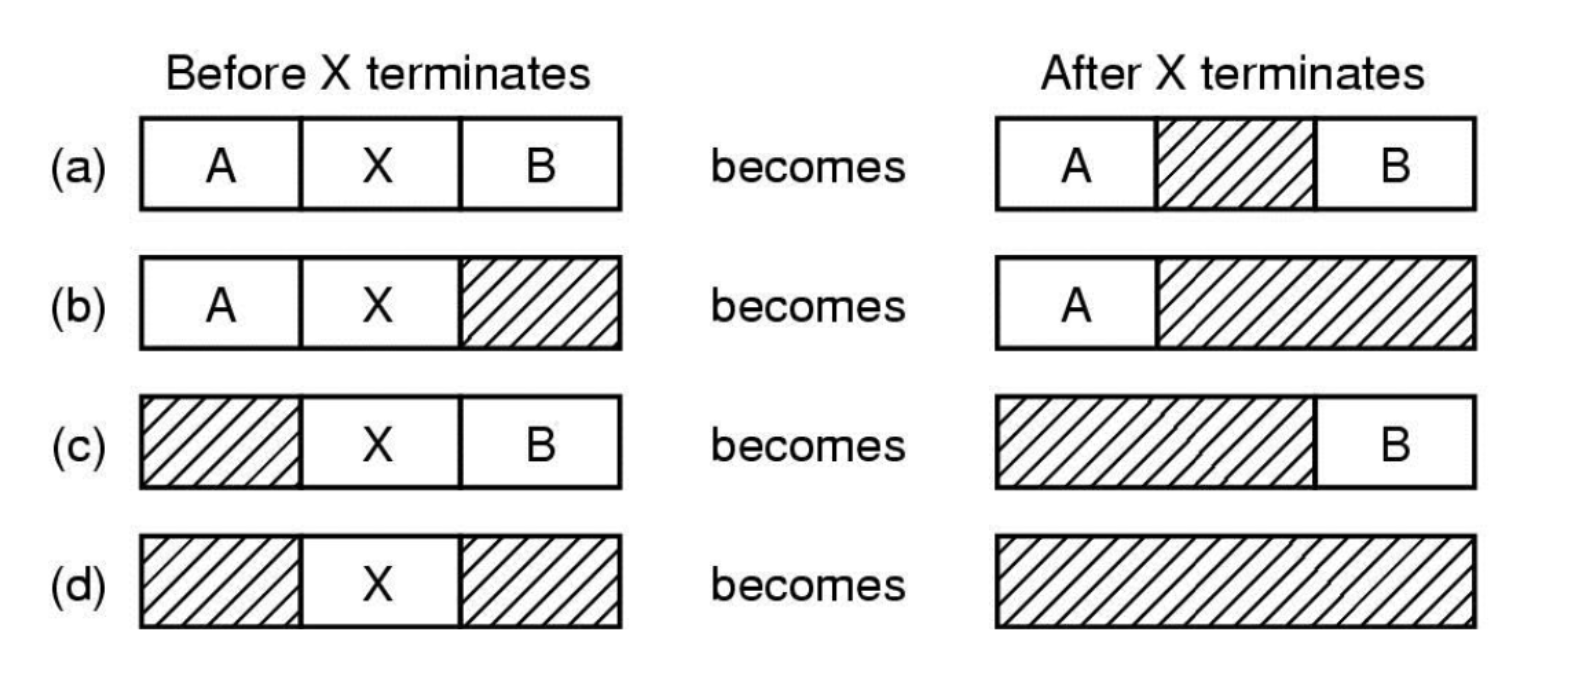
위와 같은 상황을 보자.
(a)에서 X가 종료되면 노드의 개수는 변하지 않는다.
(b)에서는 3개에서 2개로 준다.
(c)에서는 2개
(d)에서는 1개로 노드의 개수가 두 개 감소한다.
새로운 프로세스를 할당할 때에는 3가지 기준이 있다.
Fisrt Fit - 가장 먼저 만나는 충분한 크기의 H에 할당
Best Fit - 전체 리스트를 순회하고 가능한 가장 fit한 H에 할당
Worst Fit - 전체 리스트를 순회하여 가장 큰 H에 할당
*Worst Fit의 경우 best fit의 방식도 조금씩 자투리가 생기기에 가장 큰 홀에 프로세스를 할당해 큰 자투리를 만들어 할당하자는 아이디어
Virtual Memory
프로그램이 너무 커서 할당 가능한 메모리 영역이 없을 때 프로그램의 일부만 메인 메모리에 올라와 있으면 실행을 허용하는데, 이를 Overlay와 Virtual Memory로 구현한다.
Overlay의 경우 큰 프로그램을 여러 단위(오버레이)로 쪼개어 각 오버레이들을 스와핑하며 실행하는 것이다.
이 경우 프로그래머가 직접 오버레이를 어떻게 나눌 지 정해줘야 하므로 번거롭다.
Virtual Memory는 컴퓨터가 알아서 처리하도록 paging을 사용하여 구현한 방법이다.
Virtual Memory에서는 상대 주소인 Virtual Address를 사용하는데 이는 프로그램이 생성하는 주소로 이 주소들이 모여 Virtual Address Space(가상 주소 공간)를 형성한다. 이 공간 하나의 단위를 page라 부른다.
이는 가상의 공간으로 실제 메모리가 갖는 공간보다 큰 크기를 갖는데 이 가상 메모리를 실제 메모리에 맞추기 위해 실제 메모리에서는 page frame이라 불리는 단위를 사용하고 이 크기는 page와 같다.
즉, 디스크의 프로그램을 램으로 가져와 실행할 때에는 페이지 단위로 가져와 실행하는 것이다. (반대의 경우도 마찬가지)
이제 가상 주소와 실제 주소의 변환은 어떻게 하는지 알아보자.
우선 가상 주소와 실제 메모리 주소는 page table에 의해 제공된다.
주소 매핑은 MMU(Memory Management Unit)의 역할로 속도가 매우 빨라야 하기에 CPU와 메모리 사이에 위치한다.
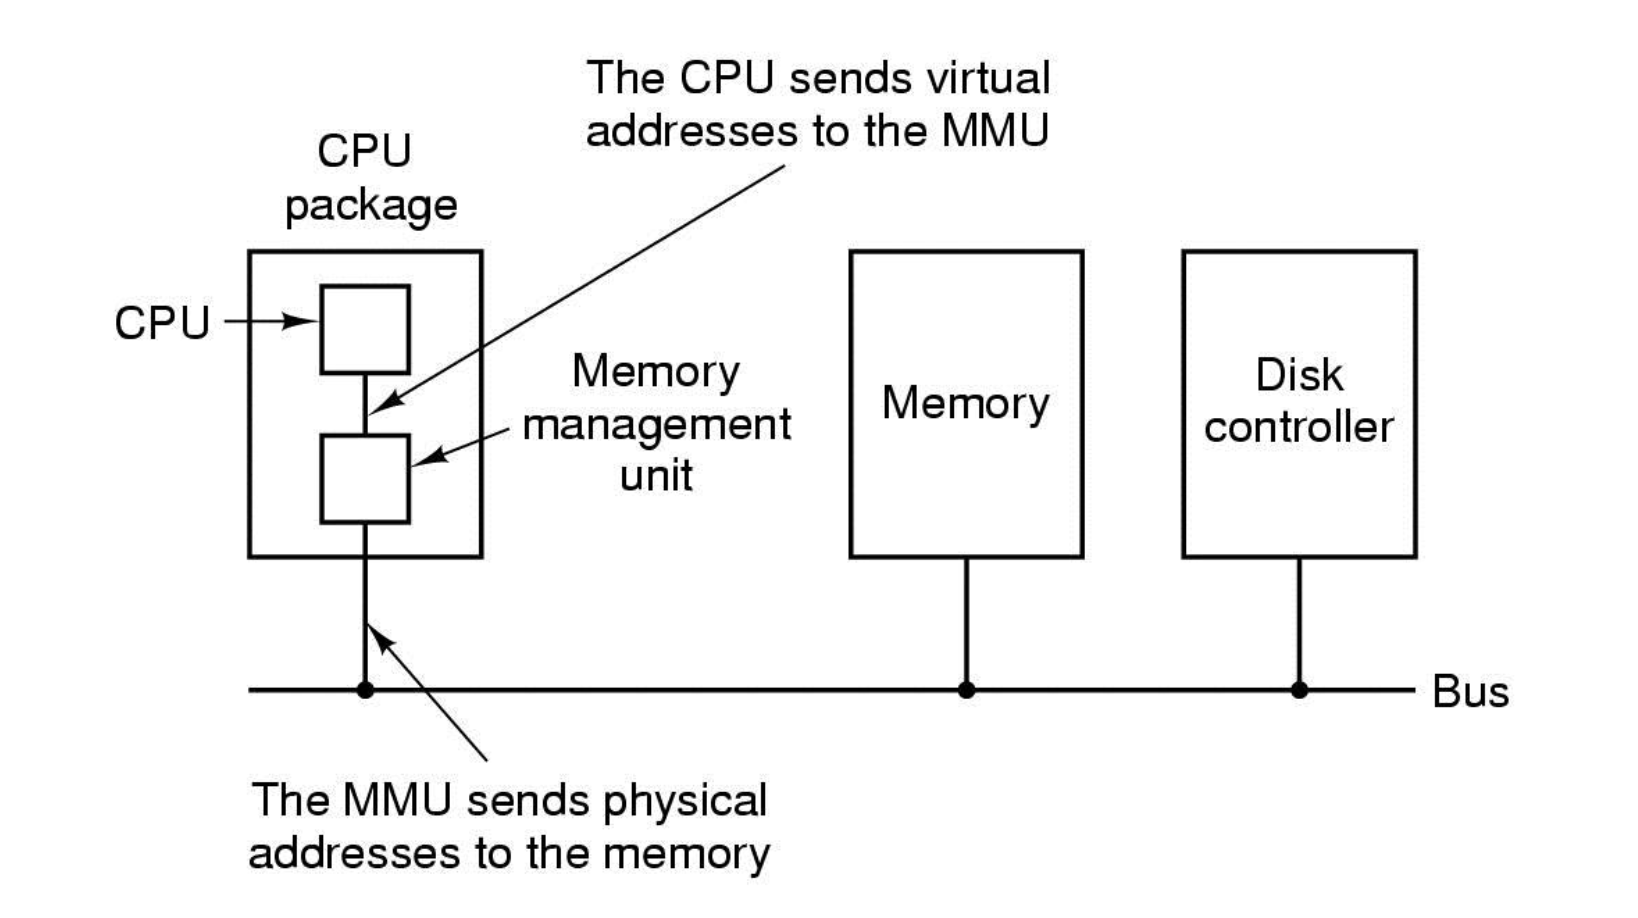
CPU에서 뭔가를 수행할 때 MMU에서 가상 주소를 실제 주소로 변환한 뒤 이 변환된 주소로 접근하는 것이다.
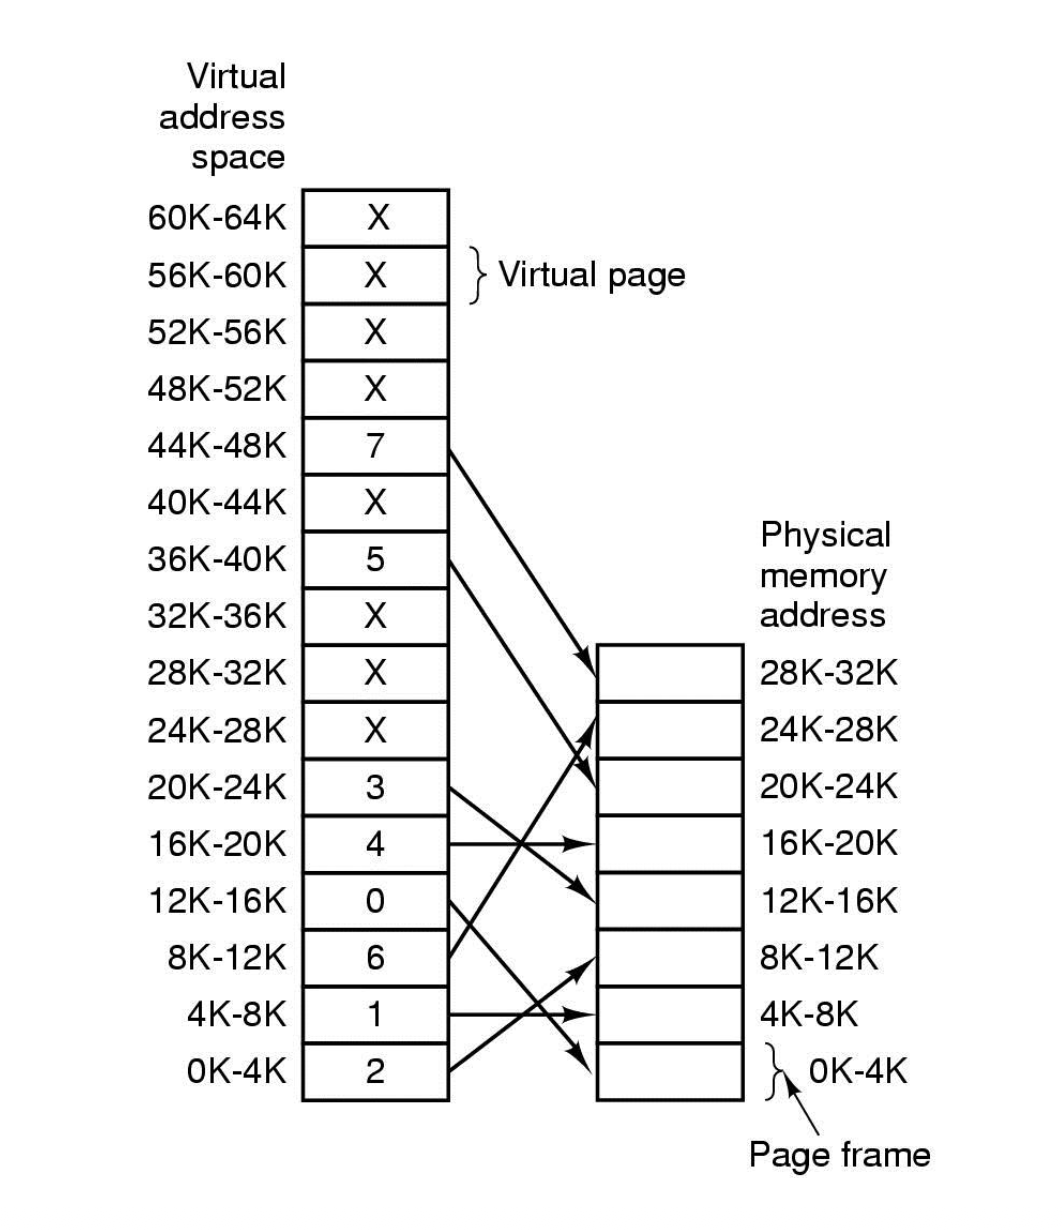
위와 같이 가상 주소 공간은 실제 저장 공간에 비해 훨씬 크다.
위 그림에선 페이지 단위는 4K 바이트로 보이고 가상 주소 공간은 64K Byte, 실제 메모리 공간은 32K Byte이다.
OS는 virtual page가 어떤 인덱스의 page frame으로 매핑되는지 page table에 기록한다. 당연히 virtual page의 크기가 더 크므로 매핑되지 않은 페이지가 존재할 것이고 매핑되지 않은 페이지를 참조하려 할 때에는 기존의 매핑된 페이지(페이지 프레임에서)를 디스크로 내려보내고 공간을 만들어 가상 페이지를 가져올 것이다. 이를 Page fault가 발생했다고 한다. - 프로그램이 가상 주소를 요청했는데 해당 주소가 RAM에 없는 경우, 보통 가장 오래된 페이지 프레임을 비운다.
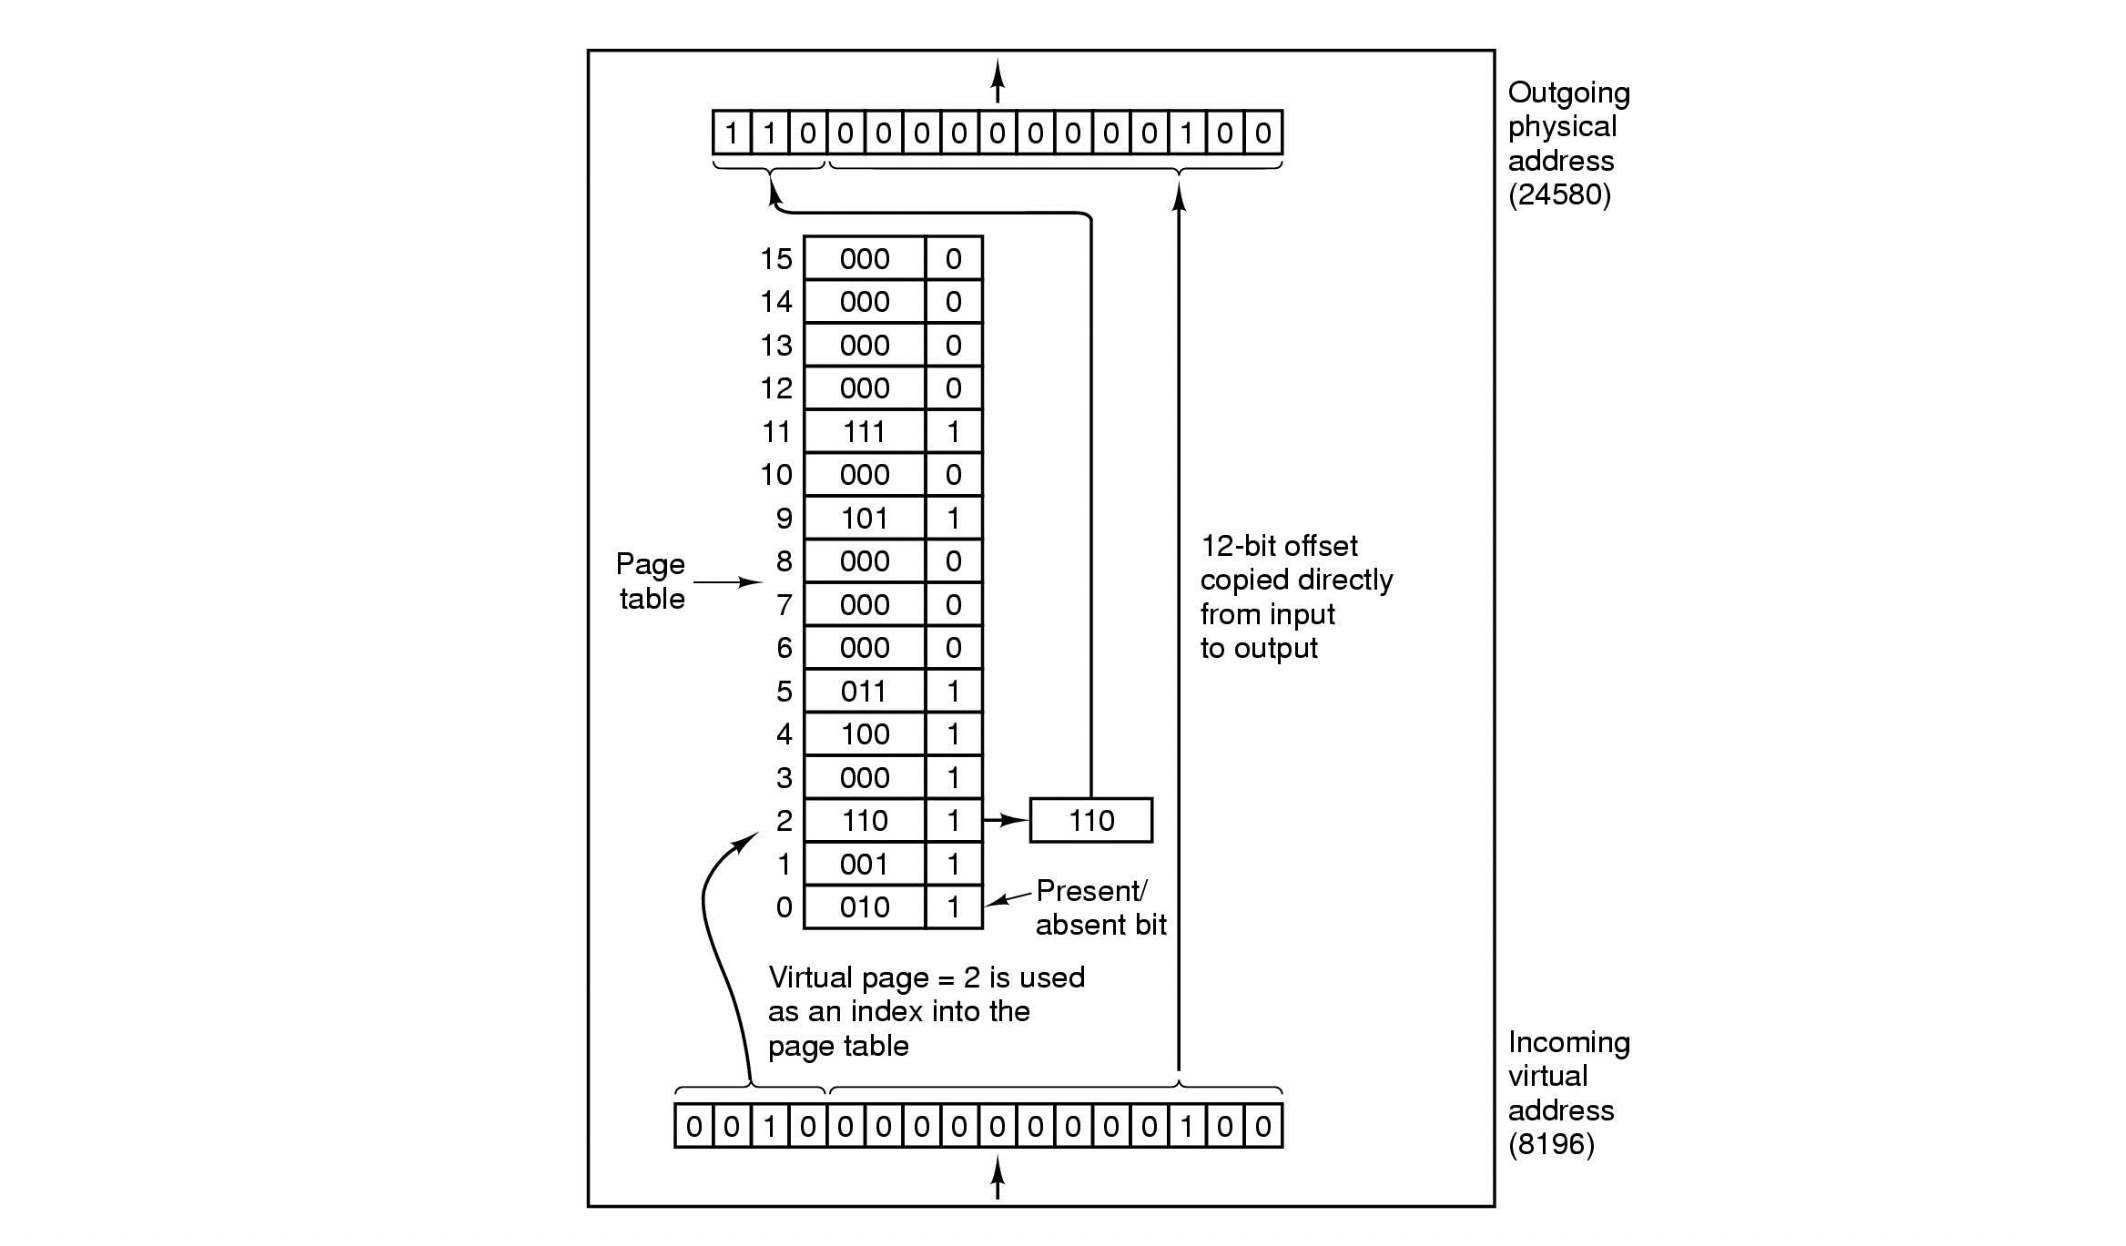
위는 페이지 테이블이다. 그림의 윗부분은 physical address로 15bit, 아래는 virtual address로 16bit인데 0~11까지 12bit는 페이지 단위가 4K이므로 이 크기를 나타내고 (4 * 2^10) 물리적인 메모리 공간은 8개의 페이지였으므로 앞에 3비트가, 가상 페이지는 16개의 페이지가 존재하므로 4비트가 붙는다.
실제 매핑되는 과정을 보면 8196이라는 가상 주소가 들어왔을 때, 이진수 상으로 12~15bit인 0010은 십진수로 2이므로 페이지 테이블의 2번 index로서 참조하게 된다. 이는 110을 가리키므로(매핑) 실제 메모리 주소는 110 ~ 이 됨을 알 수 있다.(24580)
페이지 테이블에는 두 가지 중요한 이슈가 있다.
첫번째로 페이지 테이블은 매우 커질 수 있다는 것.
32비트 주소 체계라면 100만개의 4KB 페이지가 존재하므로 1m 크기의 페이지 테이블이 필요할 것이다.
두번째로 매핑속도가 빨라야 한다는 것이다.
메모리에 접근 시마다 페이지를 참조하므로 당연히 빨라야 할 것이다.
이 매핑 속도를 위해 MMU에 페이지 테이블을 구성하거나 메인 메모리에 페이지 테이블을 구성하는 방식이 존재한다.
모든 페이지를 CPU에 저장하면 메모리에 접근하지 않아도 되어 변환 속도는 매우 빠르지만 프로세스 전환 시 각 프로세스 별 페이지 테이블을 위해 메모리를 다녀와야 하므로 크기가 큰 페이지 테이블의 경우 비용이 엄청나다는 단점이 있다. (메모리 > CPU로 페이지 테이블을 복사해와야 하므로 병목)
메모리에 페이지 테이블을 구성하는 경우 프로세스 별 페이지 테이블 전환은 빠르나 메모리 접근 시 속도가 느리다는 단점이 있다.
Multi Level Page Table
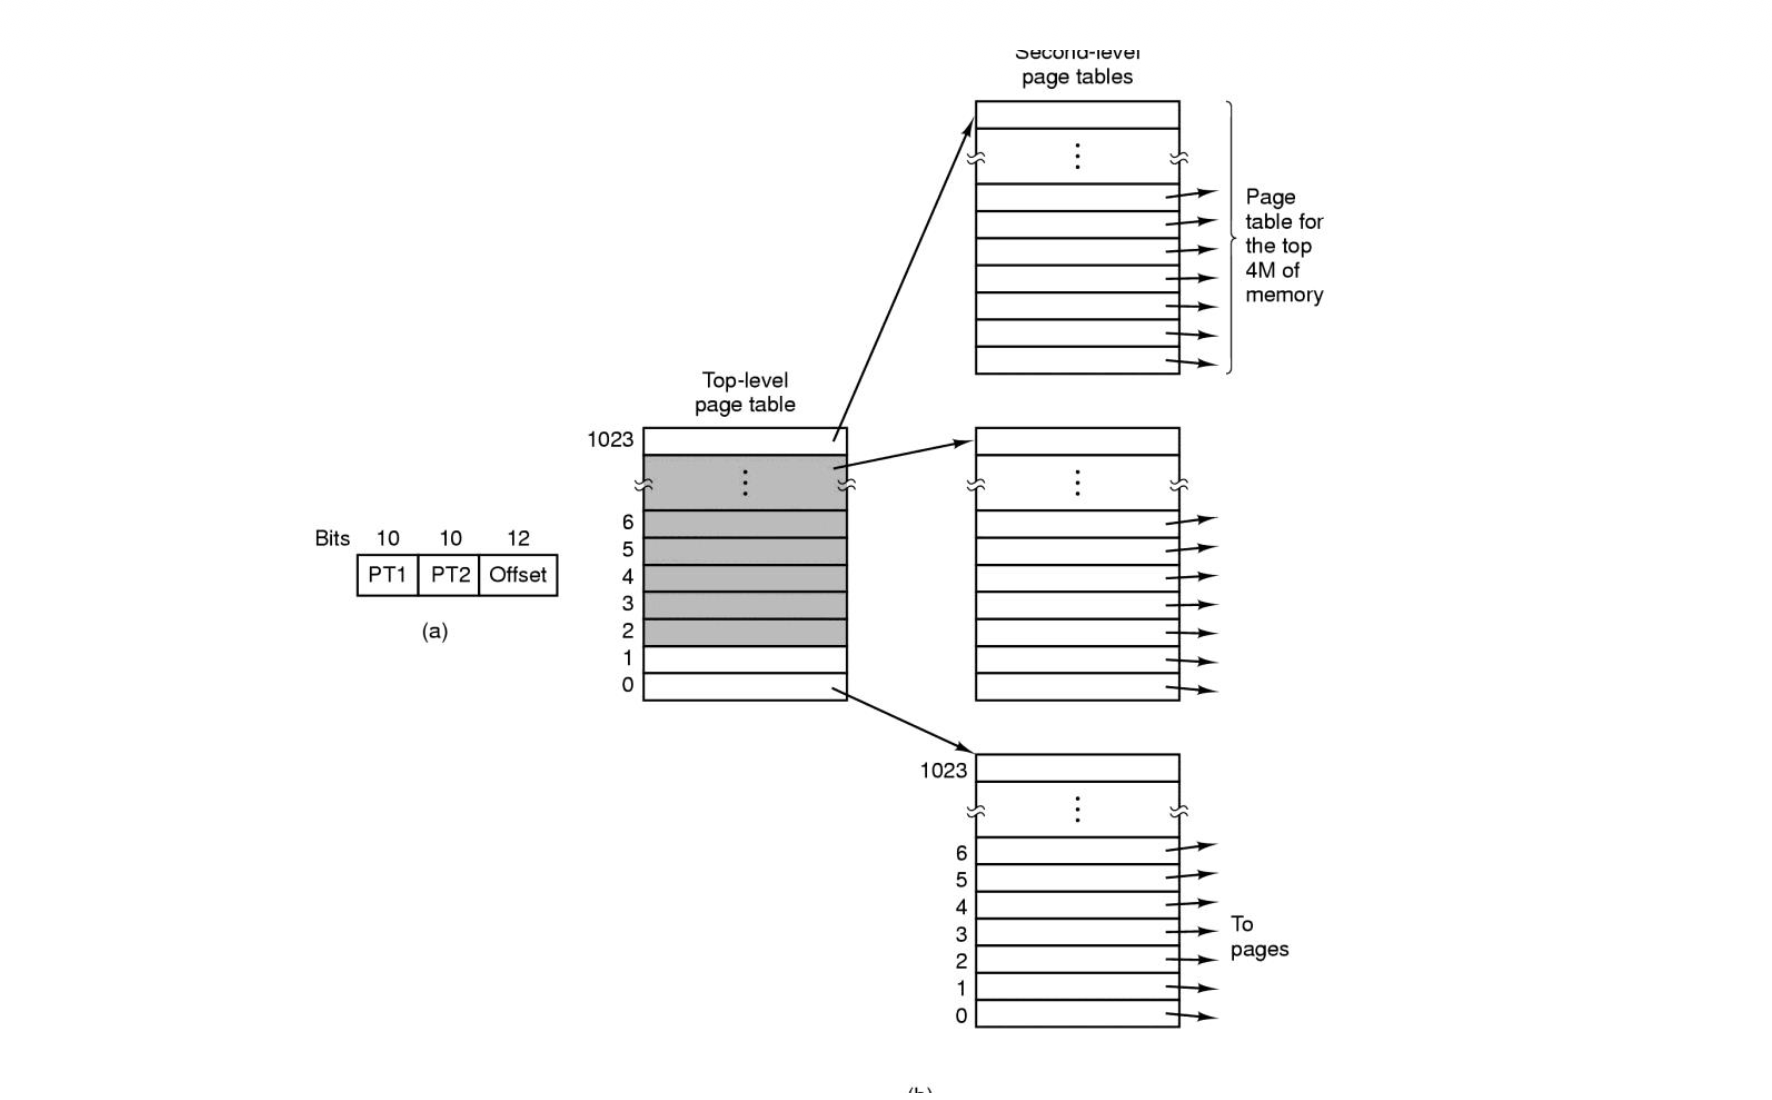
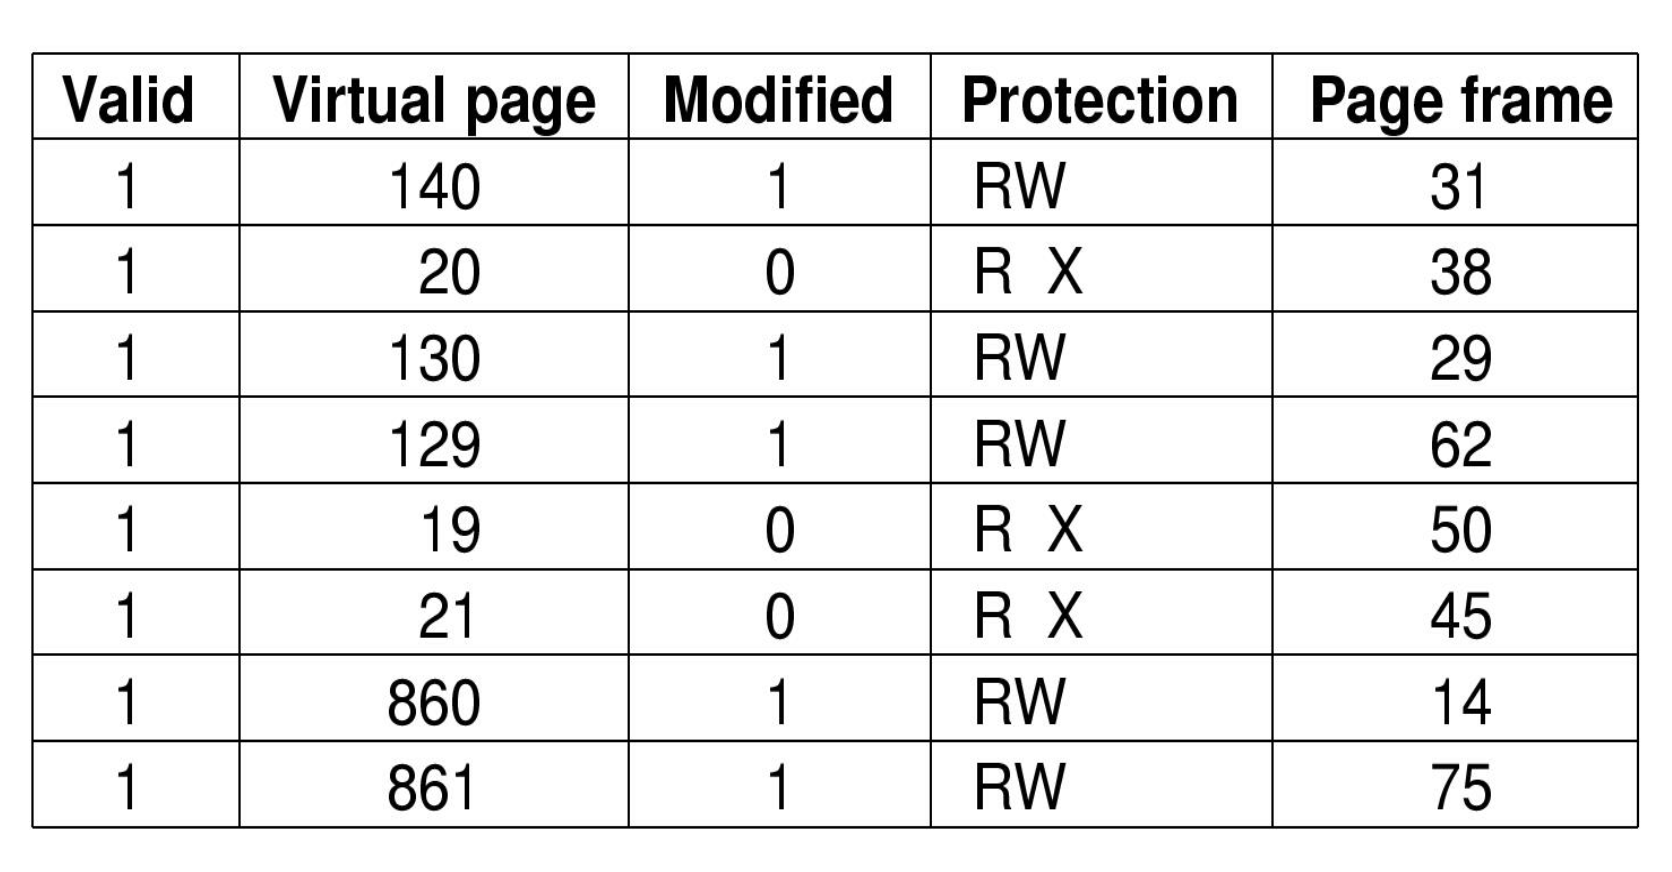
위의 사진에서 32bit 주소 체계에서 페이지 테이블 엔트리를 표현한다면 offset 12bit를 제외하고 2^20승, 약 백만개의 페이지 테이블 엔트리가 존재한다. 이에 편의를 위해 상위 10비트를 top-level page(PT1)로 중간의 10비트를 second-level page(PT2)로 하여 엔트리를 표현하면 100만개의 엔트리를 메모리에 올려둘 필요 없이 상위 10비트, 하위 10비트 총 2048개의 엔트리만 메모리에 올려두면 된다.
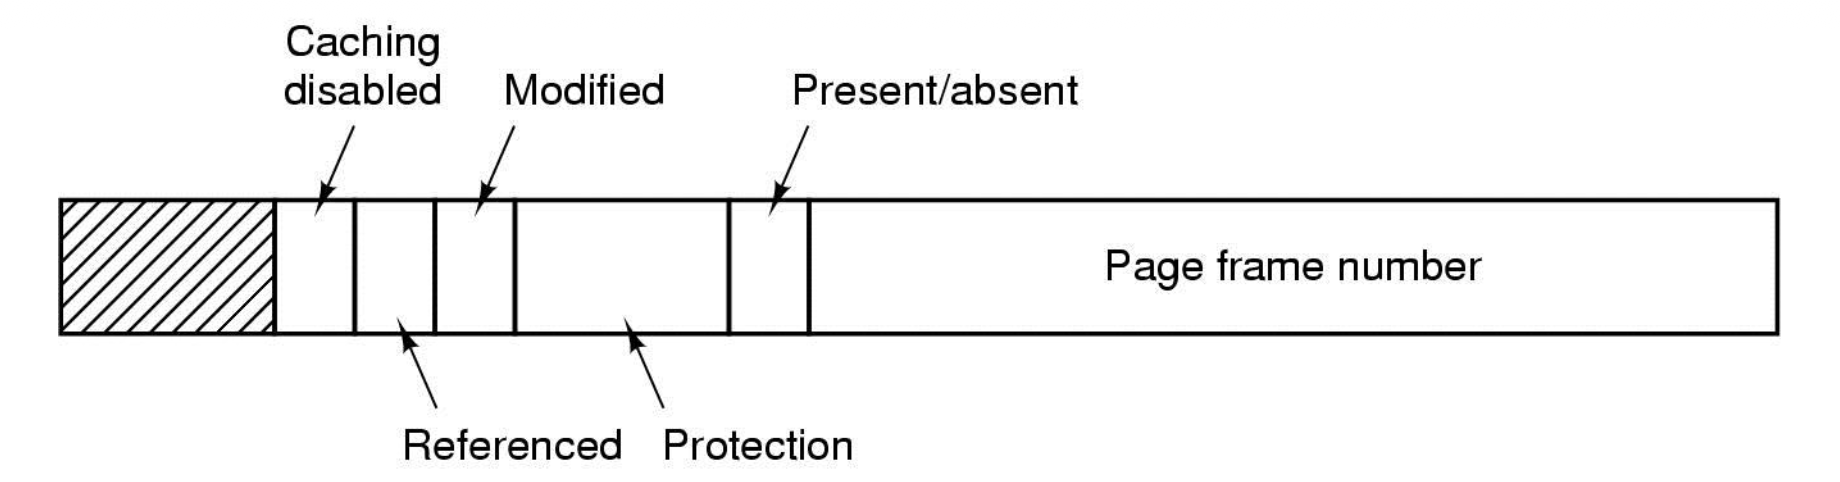
페이지 테이블 엔트리는 위와 같이 구성된다.
Page frame number: 실제 메모리에 어디에 위치하는지
Present/absent: 물리 메모리에 존재하는지 여부. 1이면 valid, 0이면 Invalid
Protection: 1이면 read-only 0이면 write도 가능
Modified: M bit, 변경 여부를 나타내는 비트. dirty bit라고도 한다.
Referenced: R bit, 참조 여부를 나타내는 비트. Read/Write가 발생했다는 것
TLB
TLB는 페이지 테이블을 위한 캐시 하드웨어이다. 참조하는 페이지를 자주 참조하는 경향이 있어 아예 캐시 메모리에 올려다놓고 쓰자는 것이다. 작동과정은 우리가 아는 캐시 메모리와 유사하다.
MMU에 주소 변환 요청을 하면 먼저 TLB에서 hit/miss 여부를 확인
hit면 그대로 가져와서 사용, miss면 메모리에서 가져온다.
TLB가 꽉 차있다면 하나를 버리고 그 위에 덮어쓰는데 이 때 dirty bit가 1이라면 메모리도 업데이트한다.